AI-Kosten: Lokal vs Cloud vs Hybrid
Grundlagen · 6 min
Was kostet AI 2026? Hier ist der realistische Vergleich für lokale Modelle, Cloud APIs und Hybrid.
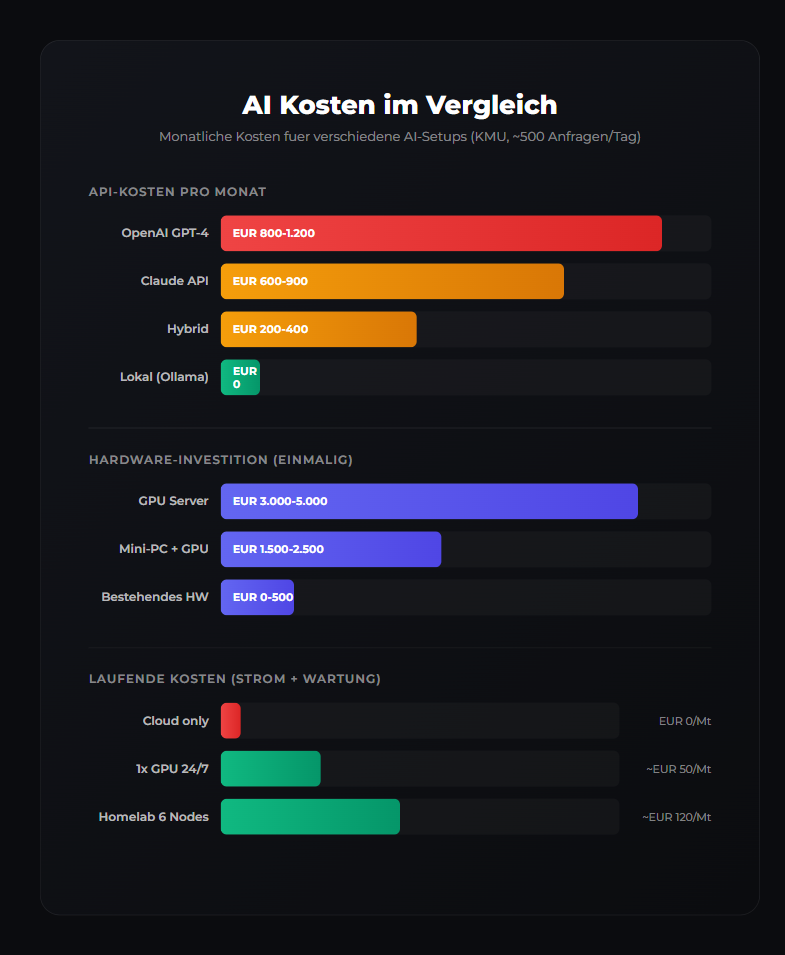
Kostenübersicht 2026 (ehrlich)
| Option | Hardware (einmalig) | Laufend/Monat | Was du bekommst |
|---|---|---|---|
| Cloud API (GPT-4o) | EUR 0 | EUR 100-500 | Beste Qualität — $5/$15 pro 1M Tokens (Stand März 2026) |
| Cloud API (Claude Sonnet 4) | EUR 0 | EUR 50-200 | Sehr gute Qualität — $3/$15 pro 1M Tokens |
| Cloud API (Gemini 2.5 Pro) | EUR 0 | EUR 30-150 | Stark bei Reasoning — $1.25/$10 pro 1M Tokens |
| Lokal (RTX 3090, gebr.) | EUR 750-1.123 | ~EUR 49 (Strom, AT) | Bis 34B Modelle, 80% der Tasks gut |
| Lokal (RTX 4090) | EUR 1.800-2.000 | ~EUR 49 (Strom, AT) | Wie 3090, etwas schneller, gleiche VRAM-Grenze |
| Hybrid (unser Setup) | EUR 750-1.123 | EUR 70-90 (Strom + Cloud) | Bester Kompromiss aus Kosten und Qualität |
Lokale AI kostet EUR 750-2.000 einmalig für die GPU plus EUR 500-800 für das System. Dazu kommen ~EUR 49/Monat Stromkosten bei 50% Last (AT: EUR 0,34/kWh). "Kostenlos nach Anschaffung" ist falsch. TCO Jahr 1: ca. EUR 2.000-2.300, ab Jahr 2: ca. EUR 588/Jahr (nur Strom).
Hardware-Optionen (Preis-Leistung)
| GPU | Preis (EUR) | VRAM | Modelle | Strom/Monat (50% Last, AT) |
|---|---|---|---|---|
| RTX 3060 12GB | ~350 | 12 GB | Nur 7B Modelle | ~EUR 21 |
| RTX 4070 Ti Super | ~800 | 16 GB | Bis 14B | ~EUR 24 |
| RTX 3090 (gebraucht) | 750-1.123 | 24 GB | Bis 34B quantisiert | ~EUR 49 |
| RTX 4090 | 1.800-2.000 | 24 GB | Bis 34B komfortabel | ~EUR 55 |
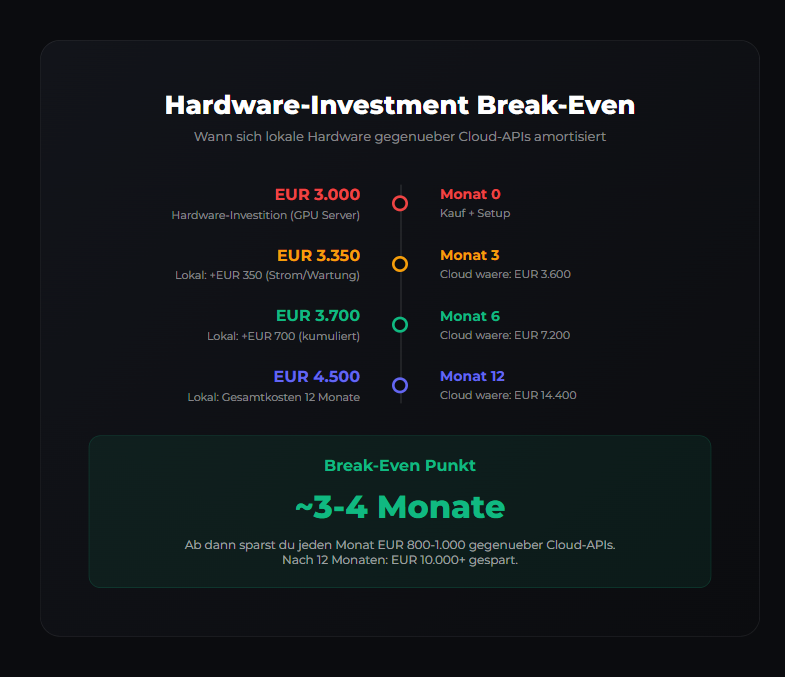
Break-Even (ehrlich)
Der echte Break-Even für Self-Hosting liegt laut DevTk.AI bei 50-200 Millionen Tokens pro Monat. Unter 2M Tokens/Tag ist die Cloud API günstiger (Prem AI). Die versteckten Kosten (Engineering, Wartung, Updates) werden laut AISuperior 3-5x unterschätzt, der Engineering-Anteil macht 45-55% des TCO aus.
Selbst wenn lokal günstiger ist: Für komplexes Reasoning (Logik, juristische Analyse, mehrstufige Aufgaben) liegt Cloud ~25% vorne. Der Break-Even gilt nur für Tasks, die lokale Modelle auch wirklich gut können.
| Task | GPT-4o (Cloud) | Llama 3.3 70B (Lokal) |
|---|---|---|
| Reasoning / Logik | 69% | 44% |
| Klassifikation | 73% | 70% |
| Code Generation | Sehr gut | ~85-90% der Cloud-Qualität |
| Einfache Extraktion | Exzellent | ~95% gleichwertig |
Quellen
- OpenAI Pricing, März 2026 — GPT-4o $2.50/$10, GPT-4o-mini $0.15/$0.60 pro 1M Tokens
- Anthropic Pricing, März 2026 — Claude Sonnet $3/$15, Opus $5/$25 pro 1M Tokens
- Google Gemini Pricing, März 2026 — Gemini 2.5 Pro $1.25/$10 pro 1M Tokens
- GlobalPetrolPrices: Austria 2026 — Strompreis AT Privat EUR 0,34/kWh
- BestValueGPU: RTX 3090 — Gebrauchtpreise EUR 750-1.123
- DevTk.AI: Self-Hosting vs API 2026 — Break-Even bei 50M-200M Tokens/Monat
- Prem AI: Self-Hosted LLM Guide 2026 — Unter 2M Tokens/Tag ist API günstiger
- AISuperior: LLM Deployment Cost — Hidden Cost Faktor 3-5x, Engineering 45-55%
- LocalAIMaster: Best GPUs for AI — Inference Speed RTX 3090
- Vellum: Llama 3.3 70B vs GPT-4o — Benchmark-Vergleich MMLU, HumanEval, IFEval
Empfehlung
Starte mit Cloud, wenn du schnell testen willst oder geringe Nutzung hast. Für laufende Workloads (Automation, interne Tools) lohnt sich lokal nach 6-12 Monaten. Der ehrlichste Ansatz ist Hybrid: lokal für Volumen-Tasks (Extraktion, Klassifikation, Q&A), Cloud-API für komplexes Reasoning. So bekommst du das Beste aus beiden Welten — ohne dir etwas vorzumachen.
Lokal für 80% der alltäglichen Tasks. Cloud-API für die 20% wo Qualität kritisch ist. Investition: EUR 750-1.123 Hardware + EUR 70-90/Monat laufend (Strom + Cloud). Das ist weniger als reine Cloud, aber auch nicht "kostenlos".
War dieser Artikel hilfreich?
Weiter im Lernpfad
Der Lernpfad bringt diese Artikel in eine Reihenfolge, und der Hub führt die Bausteine, die wir im eigenen Betrieb geprüft haben.
- Lokal und selbst gehostet
- Dokumentiert und prüfbar
- Aus eigenem Betrieb
- Made in Austria